
T1: Terminal Agent Reinforcement Learning for Long-Horizon Tasks
Junyao Yang†, Yucheng Shi, Zhongzhi Li, Ruhan Wang, Zongxia Li, Haitao Mi, Leowei Liang
- Equal contribution · † Corresponding author
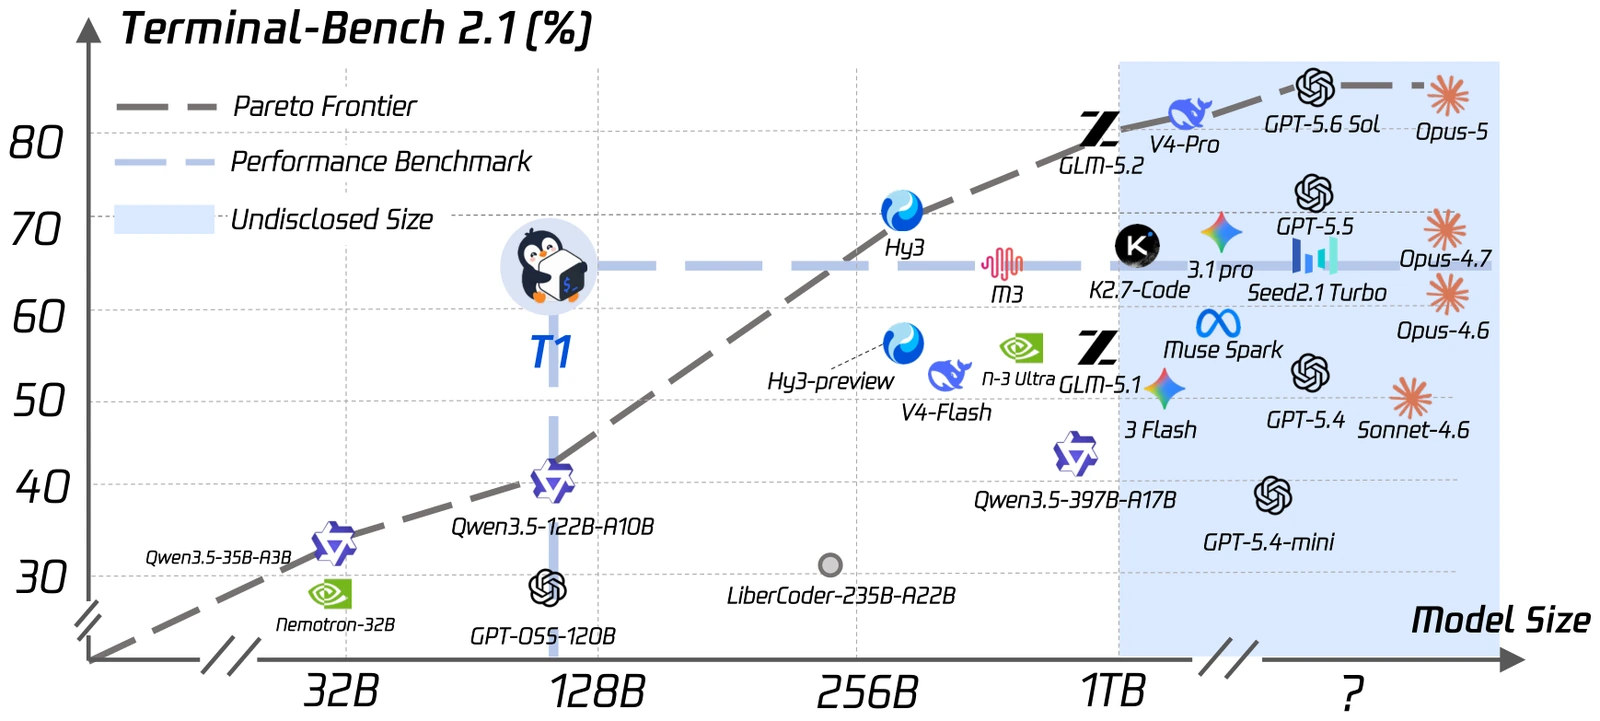
A 122B MoE terminal agent trained with reinforcement learning for long-horizon tasks. Stable MoE optimization, token-in token-out training, routing replay, and dense verification rewards support reliable shell interaction across hundreds of tool-call turns.