
RewardDS: Privacy-Preserving Fine-Tuning for Large Language Models via Reward Driven Data Synthesis
Jianwei Wang, Chengming Shi, Junyao Yang, Haoran Li, Qianli Ma, Huiping Zhuang, Cen Chen, Ziqian Zeng†
† Corresponding author
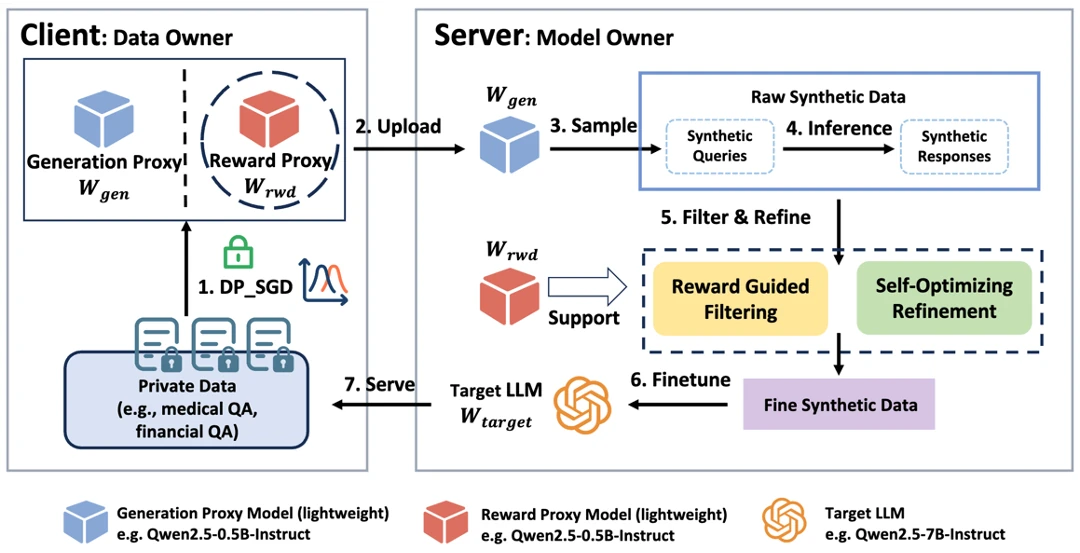
Reward proxy models guide the filtering and self-optimizing refinement of synthetic data for privacy-preserving LLM fine-tuning. This reduces noise in generated supervision while protecting sensitive training data.